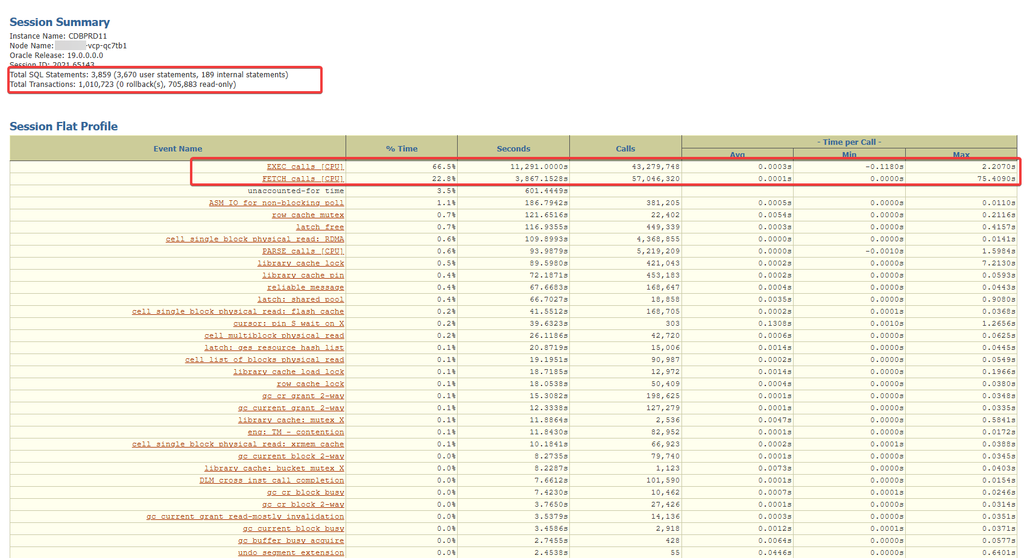
Esta semana, estive envolvido em um problema de performance que, até então, nunca havia enfrentado. Um cliente relatou que um determinado job, responsável pela execução de aproximadamente 3.859 SQL_IDs distintos, estava apresentando uma degradação significativa em seu tempo de execução.
Normalmente, esse job era executado dentro de uma janela de aproximadamente 2 a 4 horas, dependendo do volume de dados processado naquele momento. No entanto, o tempo de execução começou a aumentar, impactando diretamente o processamento e a janela operacional do ambiente Exadata X11.
Informações e configurações do ExaCS X11.
[root@vcp-qc7tb1 ~]# uname -r
5.15.0-308.179.6.7.el8uek.x86_64
[root@vcp-qc7tb1 ~]# uname -a
Linux vcp-qc7tb1 5.15.0-308.179.6.7.el8uek.x86_64 #2 SMP Thu Jun 12 20:04:53 PDT 2025 x86_64 x86_64 x86_64 GNU/Linux

[root@vcp-qc7tb2 ~]# uname -r
5.15.0-308.179.6.7.el8uek.x86_64
[root@vcp-qc7tb2 ~]# uname -a
Linux vcp-qc7tb2 5.15.0-308.179.6.7.el8uek.x86_64 #2 SMP Thu Jun 12 20:04:53 PDT 2025 x86_64 x86_64 x86_64 GNU/Linux

[root@vcp-qc7tb1 ~]# nproc
46
[root@vcp-qc7tb1 ~]# free -lgh
              total        used        free      shared  buff/cache   available
Mem:          983Gi       595Gi       311Gi        12Gi        75Gi       354Gi
Low:          983Gi       671Gi       311Gi
High:            0B          0B          0B
Swap:          15Gi        11Mi        15Gi

[root@vcp-qc7tb2 ~]# free -lght
46
[root@vcp-qc7tb2 ~]# free -lght
              total        used        free      shared  buff/cache   available
Mem:          983Gi       573Gi       355Gi        27Gi        53Gi       365Gi
Low:          983Gi       627Gi       355Gi
High:            0B          0B          0B
Swap:          15Gi          0B        15Gi
Total: 999Gi 573Gi 371GiDatabases existentes na versão 19c:
[oracle@vcp-qc7tb1 oratop]$ ps -ef | grep smon
grid      45469      1  0 Aug15 ?        00:00:25 asm_smon_+ASM1
oracle    62706      1  0 Aug15 ?        00:00:50 ora_smon_CDBPRD021
oracle    62893      1  0 Aug15 ?        00:00:23 ora_smon_CDBPRD21
oracle    63467      1  0 Aug15 ?        00:00:33 ora_smon_CDBPRD41
oracle    63499      1  0 Aug15 ?        00:00:32 ora_smon_CDBPRD51
oracle    63511      1  0 Aug15 ?        00:00:33 ora_smon_CDBPRD31
oracle   106647      1  0 Aug28 ?        00:00:05 ora_smon_CDBPRD71
oracle 283936 1 0 Aug28 ? 00:00:56 ora_smon_CDBPRD11Historico de execução do job:
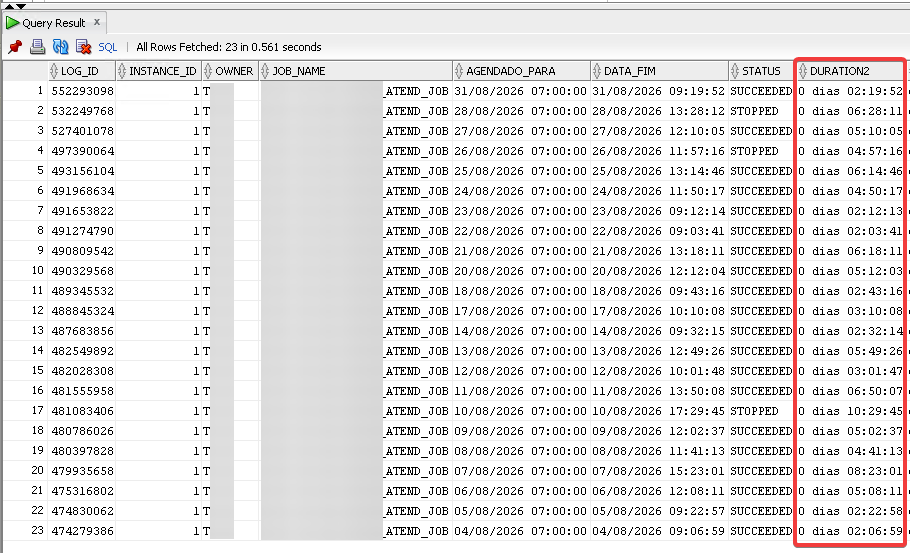
Considerando a configuração do ExaCS X11 e a quantidade de databases hospedados no ambiente, iniciei a análise avaliando a performance do job e os planos de execução de cada SQL_ID executado. Para identificar possíveis diferenças de comportamento, comparei as execuções realizadas nos melhores dias com aquelas observadas nos dias de pior desempenho.
Durante o período do incidente (01/08 a 30/08), os cabeçalhos do sar registraram 46 CPUs em 28 dos 30 dias. Por se tratar de ambiente ExaCS com OCPU elástica, essa contagem varia ao longo do tempo — houve dias com 70 e 78 CPUs. Todas as comparações apresentadas neste post usam as janelas em que o ambiente operava com 46 CPUs. Memória total: 983 GiB por nó, distribuídos em 2 nós NUMA.
Estatisticas de uma trace do job:
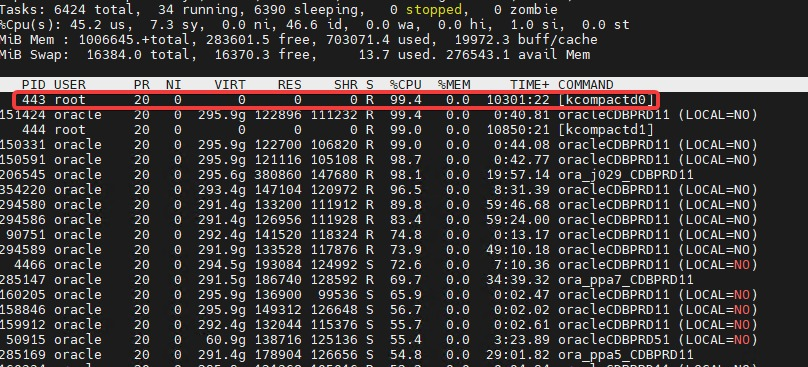
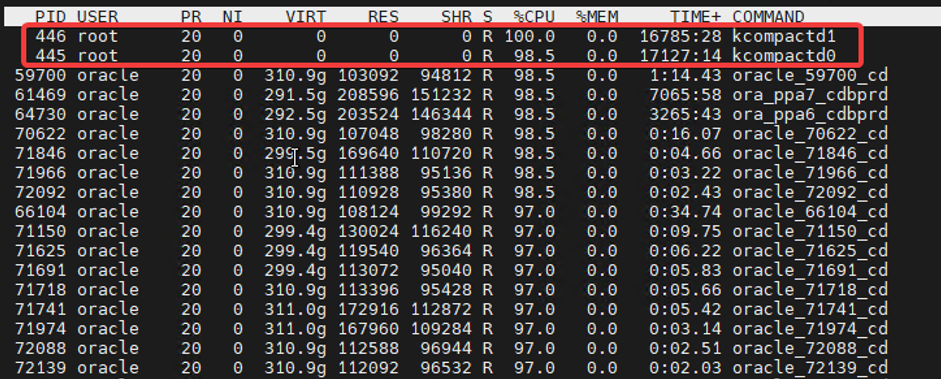
Após essa análise, o Carlos Furushima Linkedin do Carlos, que é um excelente consultor e já havia atuado em outras crises no passado, foi envolvido para olhar o problema por uma perspectiva diferente. Foi então que ele identificou o que estava acontecendo: Os processos kcompactd0 e kcompactd1, responsáveis pela compactação proativa de memória no kernel, estavam impactando o ambiente.
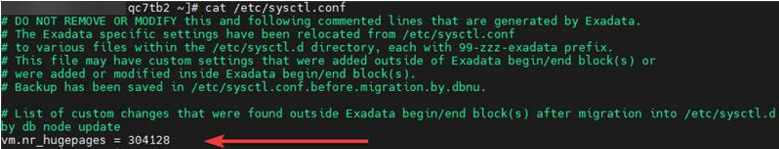
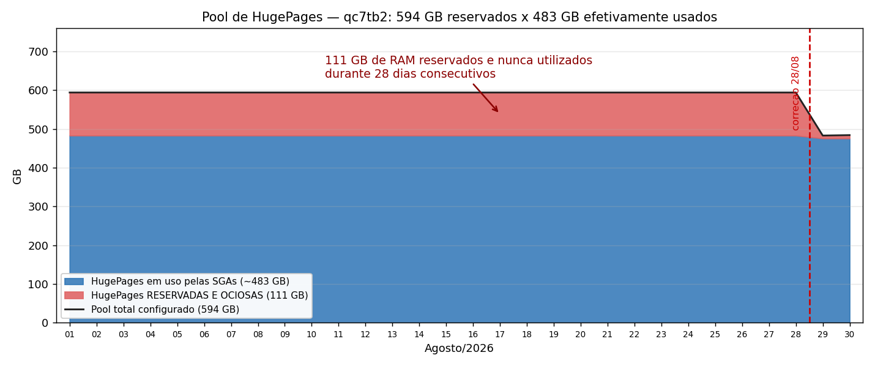
A recomendação do Carlos foi reduzir o valor configurado no parâmetro nr_hugepages, diminuindo a quantidade de HugePages estáticas reservadas no sistema, uma vez que aproximadamente 111 GB permaneciam reservados, porém sem utilização efetiva.
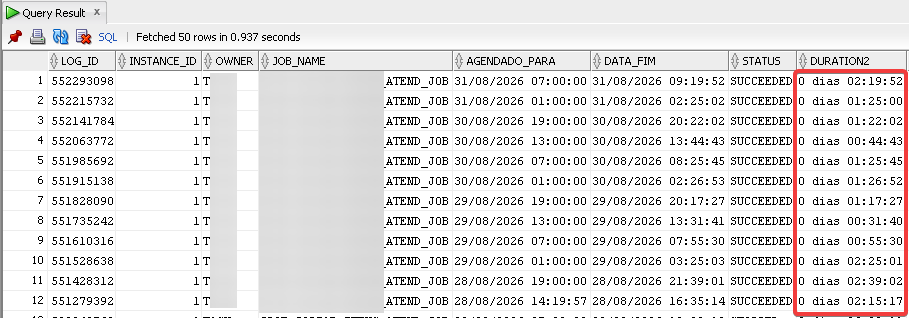
Após a alteração, o comportamento do ambiente voltou à normalidade, e o job passou a ser executado novamente dentro da janela anteriormente observada, com tempo de execução de, no máximo, 2 horas e 30 minutos.
Mesmo depois da correção do problema, fiquei com essa questão na cabeça. Eu queria entender melhor o que realmente havia acontecido e, principalmente, qual era a causa raiz do problema. Por isso, fui estudar o comportamento desse mecanismo do kernel e pesquisar mais a fundo o que estava acontecendo no ambiente. Abaixo, compartilho os detalhes dessa análise e o que consegui entender durante a pesquisa.
Vamos entender o funcionamento da compactação proativa para o kernel:
1 – A compactação proativa (vm.compaction_proactiveness) foi introduzida no kernel 5.9 e chegou ao ambiente com o UEK7. Ela não existia no UEK6 nem no Oracle Linux 7.
2 – As threads kcompactd acordam a cada 500 ms e calculam o fragmentation score do nó.
3 – Com o valor padrão de proatividade 20, os limiares são: inicia acima de 90, para abaixo de 80.
4 – A compactação executa até o score cair ao limiar inferior ou até uma condição de desistência.
O Sintoma Observado no sistema operacional relacionados ao uso de CPU pelo processo do kcompactd:
Evidências coletadas com o SAR:
Evidência 1 – Saída do top em 29/08/2026 mostrando kcompactd0 a 100,0% e kcompactd1 a 99,7% de CPU, com tempo acumulado de 17080:36 e 16738:33 minutos.
O campo TIME+ está em minutos. Convertendo:
| Thread | Tempo de CPU acumulado |
| kcompactd0 | 17.080 min = 284,7 horas |
| kcompactd1 | 16.738 min = 279,0 horas |
Evidência 2 – Hugepage configurado de 594,00 GB:
SGA dos Databases configurados com use_large_pages=ONLY:
| Instância | SGA |
| CDBPRD11 / CDBPRD12 | 290,50 GB |
| CDBPRD51 / CDBPRD52 | 60,00 GB |
| CDBPRD71 / CDBPRD72 | 50,00 GB |
| CDBPRD31 / CDBPRD32 | 40,00 GB |
| CDBPRD41 / CDBPRD42 | 15,00 GB |
| CDBPRD21 / CDBPRD22 | 10,00 GB |
| CDBPRD021 / CDBPRD022 | 7,42 GB |
| Total | 472,92 GB |
Desperdício: 594,00 − 482,97 (usado com overhead) = 111,03 GB de RAM reservada e ociosa.
A métrica kbhugfree permaneceu constante em 111,03 GB entre 01/08 e 28/08, em ambos os nós, enquanto a métrica %hugused permaneceu em aproximadamente 81%.
O comportamento foi representado por uma linha praticamente reta durante todo o período, sem variações significativas. Isso ocorre porque a SGA é estática e, portanto, o pool de HugePages não apresentaria crescimento para ocupar o espaço adicional reservado.
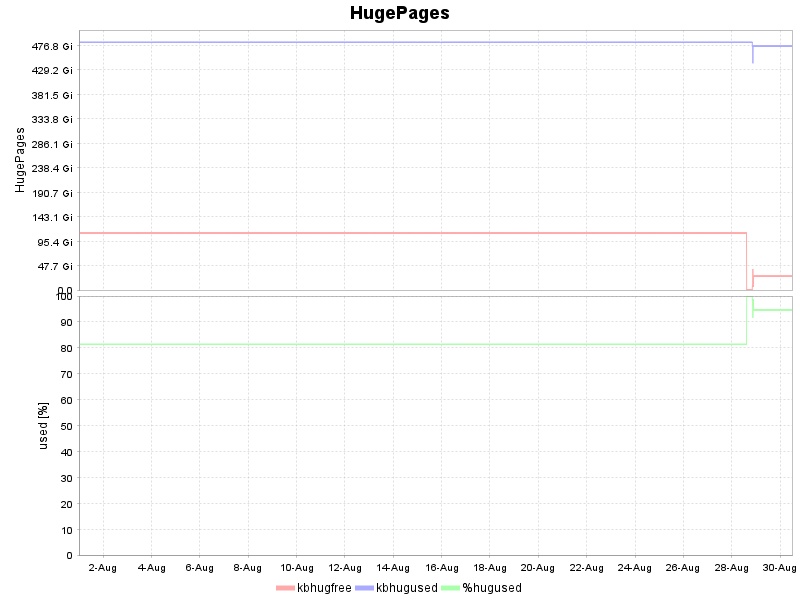
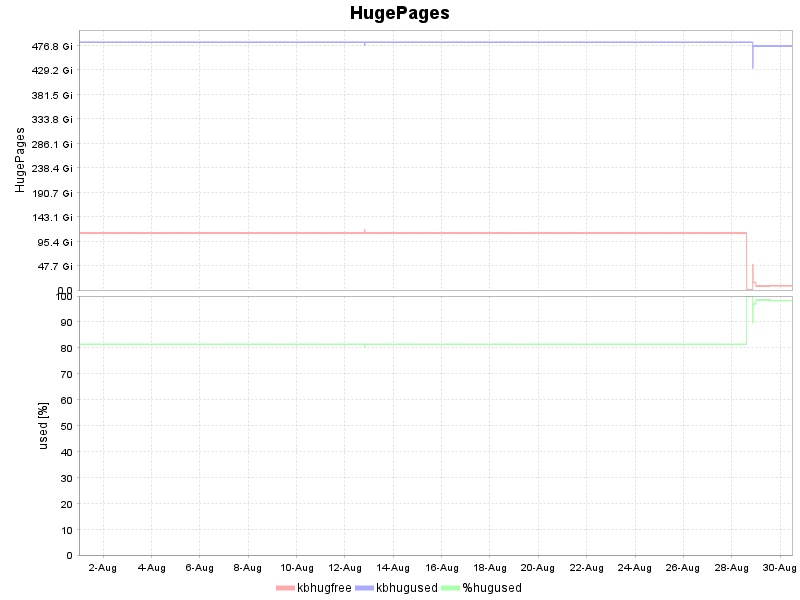
Evidência 3 – Painel HugePages do kSar (qc7tb2). Painel superior: kbhugfree (vermelho) constante em ~111 Gi. Painel inferior: %hugused (verde) cravado em 81% por 28 dias, saltando para ~98% após a correção.
Evidência 5 – Estado da memória antes da correção:
numastat -m no qc7tb2:
                    Node 0        Node 1        Total
MemTotal          503052.80     503593.88    1006646.68  MB
MemFree            69289.68       7119.35      76409.04  MB
Inactive(file)    118463.17     190421.02     308884.18  MB
HugePages_Total   247662.00     246896.00     494558.00  MB
AnonHugePages          0.00          0.00          0.00  MB
Os mesmos valores convertidos para GB:
| Métrica | Node 0 | Node 1 | Total |
| MemTotal | 491,26 GB | 491,79 GB | 983,05 GB |
| MemFree | 67,67 GB | 6,95 GB | 74,62 GB |
| Inactive(file) | 115,69 GB | 185,96 GB | 301,64 GB |
| HugePages_Total | 241,86 GB | 241,11 GB | 482,97 GB |
| AnonHugePages | 0,00 GB | 0,00 GB | 0,00 GB |
Evidência 6 – Índice de fragmentação calculado a partir de /proc/buddyinfo (2 MB, tamanho de uma huge page):
| Zona | Fragmentação ordem 9 | Fragmentação ordem 10 |
| Node 0, Normal | 96,90% | 99,76% |
| Node 1, Normal | 97,58% | 100,00% |
Com base nas evidências coletadas do ambiente, o score calculado era de 96 no nó NUMA 0 e 97 no nó NUMA 1, acima do limite de acionamento (trigger) de 90 e da meta de 80. Como 482,97 GB (aproximadamente 49% da memória RAM) estavam alocados em HugePages estáticas, essas páginas permaneciam reservadas e não podiam ser migradas durante o processo de compactação. Dessa forma, havia memória insuficientemente disponível e elegível para movimentação, impedindo que a compactação reduzisse o score aos níveis esperados.
Resultado: Meta inatingível do score, perseguida indefinidamente. As threads compactavam, não progrediam, e reiniciavam o ciclo por 285 horas de CPU acumulativas.
O kernel não avalia fragmentação de forma subjetiva — ele calcula um número inteiro por nó NUMA e o compara com dois limiares fixos. Abaixo está a fórmula conforme implementada em mm/compaction.c e mm/vmstat.c no kernel 5.15, aplicada aos valores medidos no servidor.
Índice de fragmentação por zona (extfrag_for_order, em mm/vmstat.c):
extfrag(zona, ordem) = ((Fz − Hz) / Fz) × 100
Onde Fz é o total de páginas livres da zona e Hz é o número de páginas livres que estão em blocos de tamanho igual ou maior que a ordem pedida (ordem 9 = 2 MB).
Cálculo do fragmentation score:
score(zona) = extfrag(zona, 9) × present_pages(zona) / (present_pages(nó) + 1)score(nó) = Σ score(zona)wmark_low = 100 − vm.compaction_proactiveness = 80wmark_high = wmark_low + 10 = 90
Proactive compaction for the kernel
Proactive Compaction
Linux Memory Compaction: Internals and Debugging
Aplicação aos valores medidos (qc7tb2, antes da correção):
Índices por zona calculados a partir de /proc/buddyinfo na ordem 9, e present_pages derivado do numastat -m (MemTotal de 491,26 GB no nó 0 e 491,79 GB no nó 1. As zonas DMA e DMA32 são estimadas em 0,02 GB e 3,81 GB, valores padrão em x86_64):
| Zona | present (GB) | extfrag (ordem 9) | peso | contribuição |
| Node 0 / DMA | 0,02 | 9,09% | 0,0000 | 0,00 |
| Node 0 / DMA32 | 3,81 | 0,13% | 0,0078 | 0,00 |
| Node 0 / Normal | 487,44 | 96,90% | 0,9922 | 96,15 |
| score do Node 0 | 96 | |||
| Node 1 / Normal | 491,79 | 97,58% | 1,0000 | 97,58 |
| score do Node 1 | 97 |
Interpretação:
score Node 0 = 96 > wmark_high (90) → compactação ativa
score Node 1 = 97 > wmark_high (90) → compactação ativa
meta a atingir = wmark_low (80)
Ambos os nós estavam 6 e 7 pontos acima do gatilho, e precisariam cair 16 e 17 pontos para que as threads parassem o processo de compactação.
Para solucionar o problema, ajustamos a configuração de HugePages para considerar o valor correspondente à soma total das SGA de todos os databases do ambiente. Após essa alteração, o ambiente voltou a apresentar excelente desempenho, e o job que apresentava problemas de performance retornou ao seu tempo médio de execução, restabelecendo o comportamento esperado.
Correção aplicada:
sysctl -w vm.nr_hugepages=247279Comparando as janelas de três dias antes e dois dias depois, no qc7tb1:
| Métrica | 25–27/08 | 29–30/08 | Variação |
|---|---|---|---|
%sys | 8,35% | 4,46% | −3,88 pp |
%usr | 57,40% | 57,84% | +0,44 pp |
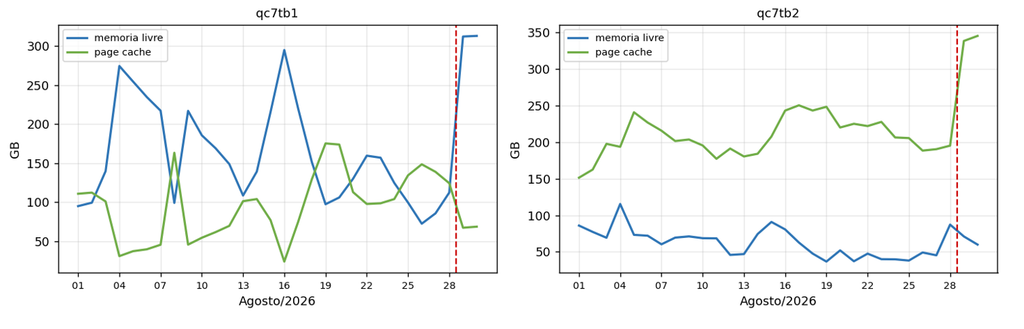
Após a alteração, no qc7tb1, a memória livre aumentou significativamente, atingindo 313 GB. No qc7tb2, observou-se um aumento do page cache, que chegou a 345 GB, evidenciando a liberação e a melhor utilização da memória anteriormente reservada.
Por que o impacto foi maior que o consumo de CPU:
Duas threads consumindo dois núcleos representam cerca de 4% de 46 CPUs. Isso sozinho não explica a degradação observada no job. O custo real foi indireto.
Contenção de locks. Para migrar páginas, o kcompactd segura o zone->lock e o lru_lock da zona. Todo processo Oracle que aloca memória — crescimento de PGA, sort, hash join, criação de processo — disputa exatamente esses mesmos locks. O tempo perdido aparece como latência de sessão, não como CPU.
Direct reclaim. Sem folga de memória livre, o reclaim acontece no contexto do processo que pediu a memória. O qc7tb2 varria cerca de 1.500 páginas por segundo continuamente durante todo o mês. Cada sessão que alocava PGA parava para fazer esse trabalho ela mesma.
TLB shootdown. Migrar página mapeada exige invalidar TLB em todas as CPUs via IPI. Com dezenas de núcleos e compactação ininterrupta, é tráfego constante de interrupções.
Infelizmente, não tivemos uma resposta conclusiva sobre alguns pontos importantes. Não ficou claro se toda a análise estava correta, se poderia existir algum problema no cálculo da compactação, considerando o valor total reservado para HugePages em vez da memória efetivamente utilizada, ou se existe alguma boa prática específica que deva ser seguida após a introdução desse mecanismo de compactação no kernel UEK7.
Durante a pesquisa, o único documento que encontrei diretamente relacionado ao problema foi o Oracle Linux: 100% CPU Utilization by kcompactd Process (KB181416). O documento orienta que, em situações de alto consumo de CPU pelo processo kcompactd, a compactação de memória seja desabilitada. No entanto, não encontrei uma documentação que explicasse de forma mais detalhada o funcionamento desse mecanismo, principalmente em ambientes Oracle Database com uma grande quantidade de HugePages estáticas reservadas.
Também enviei alguns e-mails para o time do Oracle Linux, mas, infelizmente, não obtive retorno sobre o problema apresentado.
Na minha opinião, esse é um ponto que poderia ser melhor documentado pela Oracle. Uma melhoria na própria implementação ou, pelo menos, uma nota no MOS explicando esse comportamento e indicando as melhores práticas para configuração de HugePages nesse cenário seria bastante útil.
Uma documentação mais clara ajudaria os times responsáveis pela administração dos ambientes Oracle e também toda a comunidade técnica de DBAs a entender melhor o funcionamento do kcompactd, principalmente como o processo de compactação considera as HugePages reservadas e quais cuidados devem ser tomados na configuração do nr_hugepages no UEK7.
Como recomendação, na minha opinião, a partir do UEK7, o ideal é configurar o nr_hugepages considerando apenas a quantidade de HugePages que será efetivamente utilizada pelos databases. Eu evitaria manter uma quantidade excessiva de HugePages reservadas sem utilização que antes era inofensiva até o UEK7, pois, conforme observado neste caso, essa memória permanece indisponível para outros usos do sistema e pode influenciar o comportamento do gerenciamento e da compactação de memória.
Dessa forma, a configuração deve buscar um equilíbrio entre atender à demanda real dos databases e evitar a reserva desnecessária de memória, principalmente em ambientes com grande quantidade de RAM e múltiplos databases.
Referências:
https://blogs.oracle.com/linux/reasons-to-install-uek7
https://blogs.oracle.com/linux/linux-memory-compaction-part-1
https://lwn.net/Articles/817905/
Oracle Linux: 100% CPU Utilization by kcompactd Process KB181416